Dev-Tooling
Ein Workflow, 83 Repos: Ein KI-Reviewer für jeden PR
Wie wir einen beratenden, Claude-gestützten Checklisten-Reviewer in jedes Frontend- und Backend-Repo eingebunden haben, das wir betreiben, ohne die bestehenden Review-Gates der Teams zu überrollen. Ein wiederverwendbarer Workflow, eine 15-zeilige Aufruf-Datei pro Repo und eine Checkliste, die jeder in Notion bearbeiten kann.
Jeder Pull Request in unserer Welt endete früher auf dieselbe Weise. Ein Entwickler postet den Link im #pull-requests-Slack-Channel des Teams und schreibt irgendeine Variante von „Kann das jemand mergen?”. Über rund 150 Repositories und ein Dutzend Kundenprojekte hinweg war „jemand” schlicht, wer gerade Zeit hatte, und „reviewt” bedeutete das, was diese Person zufällig geprüft hatte, bevor sie auf den Button klickte. Der Maßstab verschob sich von Repo zu Repo und von Reviewer zu Reviewer.
Wir wollten einen Reviewer auf jedem Frontend- und Backend-Repo. Etwas, das jeden PR liest, ihn gegen unsere eigene Qualitäts-Checkliste prüft und sagt, was es gefunden hat, bevor ein Mensch eine Minute daran verschwendet. Kein Gatekeeper. Wir wollten keinen Roboter, der Merges nach eigenem Gutdünken blockiert. Wir wollten ein zweites Paar Augen, das nie müde wird und nie die langweiligen Prüfungen überspringt, während die eigentliche Merge-Entscheidung bei einem Menschen bleibt.
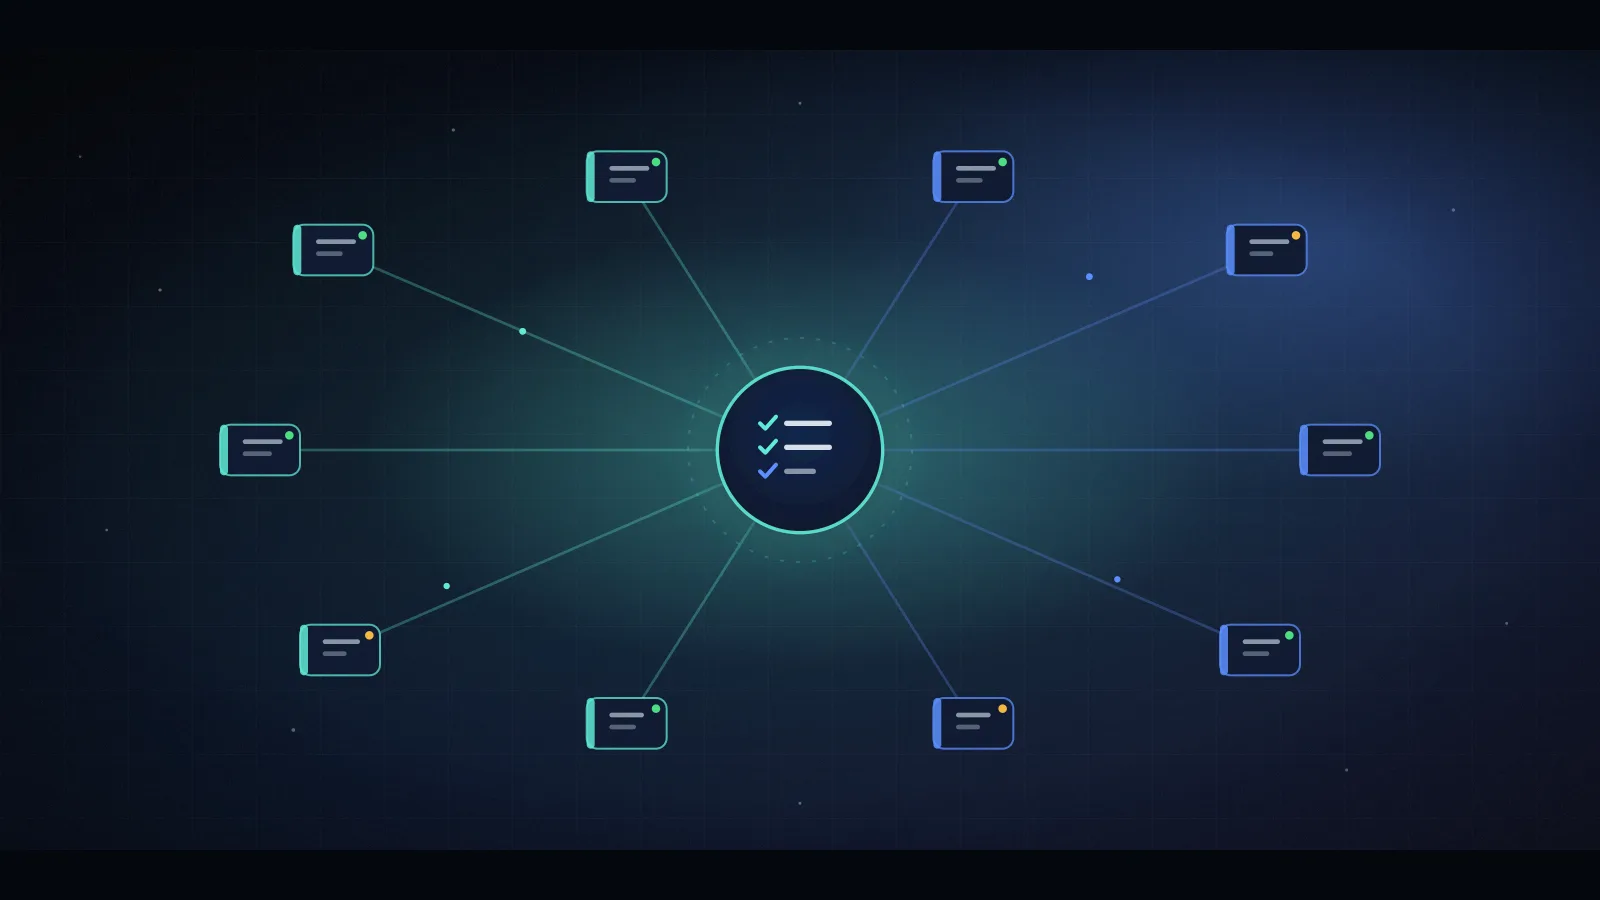
Was am Ende live ging, ist ein einziger GitHub-Actions-Workflow, der in einem Repo liegt und von allen anderen aufgerufen wird. Er ermittelt, ob ein Repo Frontend oder Backend ist, holt die passende Checkliste aus Notion, bittet Claude, das Diff dagegen zu reviewen, kommentiert den PR und postet in dem Moment, in dem der PR geöffnet wird, eine Karte in Slack. So haben wir ihn gebaut, so haben wir ihn an einem Nachmittag auf 83 Repos ausgerollt, und das sind die drei Wände, gegen die wir dabei gelaufen sind: GitHubs Anti-Missbrauchs-Limits, ein Branch-Schutz, den wir bewusst nicht übergehen wollten, und zwei Repos, die mitten im Rollout verschwanden.
Im Inneren des PR-Checklisten-Bots: ein Hub, 83 Aufrufer, ein Notion-Gehirn und die Grenzen, auf die wir stießen
1. Das Problem war das Einfügen, nicht das Review
Das Symptom war das Slack-Posting. Das eigentliche Problem war, dass nichts einheitlich war.
Unsere Repos teilen sich sauber in zwei Stacks auf: Next.js und React vorne, FastAPI hinten. Jedes Team reviewte so, wie es der jeweilige Lead bevorzugte, und ein neuer Entwickler lernte den Maßstab durch Osmose, meist nachdem er etwas ausgeliefert hatte, das hätte abgefangen werden müssen. Es gab keine gemeinsame Liste der Dinge, die wir immer prüfen, und die Dinge, die wir immer prüfen, sind genau jene, die ein müder Reviewer um 19 Uhr überspringt: das vergessene console.log, die hartcodierte URL, das Formular ohne Ladezustand, der Endpunkt ohne Auth.
Das Ziel war also eng gefasst. Jeder PR bekommt automatisch dieselbe erste Durchsicht, und das Ergebnis landet dort, wo das Team ohnehin arbeitet.
2. Ein Workflow, eine 15-zeilige Aufruf-Datei pro Repo
Die Logik lebt an genau einem Ort: einem Repo namens shared-workflows. Jedes andere Repo trägt eine 15-zeilige Aufruf-Datei, die darauf verweist.
Das ist GitHubs Muster für wiederverwendbare Workflows, und der Grund, es zu nutzen, ist Drift. Wir hätten ein Review-Skript in alle 83 Repos kopieren können. An dem Tag, an dem wir dann den Prompt ändern oder einen Bug beheben wollten, würden wir 83 Dateien bearbeiten und hoffen, dass sie synchron bleiben. Stattdessen ist die Aufruf-Datei nur ein Stub: Sie benennt den Hub-Workflow und reicht drei Secrets durch. Der Hub enthält die rund 200 Zeilen, die die eigentliche Arbeit leisten. Ändern Sie ihn einmal, und jedes Repo übernimmt die Änderung bei seinem nächsten PR.
Ein neues Repo einzubinden ist deshalb ein Kopieren, ein Einfügen und zwei Secrets. Nichts weiter.
3. Der Repo-Name entscheidet über die Regeln
Der Hub muss wissen, ob er Frontend- oder Backend-Code reviewt, weil die Checkliste unterschiedlich ist. Wir haben den Repo-Namen entscheiden lassen.
Enthält der Name „backend”, laufen die Backend-Regeln. Enthält er „frontend”, die Frontend-Regeln. Unsere Repos folgten dieser Konvention bereits, also war das Routing gratis. Für die wenigen, die es nicht tun, greift der Workflow auf die primäre Sprache zurück: Python ist Backend, TypeScript oder JavaScript ist Frontend. Was er dann immer noch nicht zuordnen kann, überspringt er, statt zu raten.
Die Checkliste selbst lebt nicht im Code. Sie lebt auf einer Notion-Seite, die auch jemand ohne Engineering-Hintergrund bearbeiten kann, und der Workflow holt diese Seite live über die Notion-API und verwandelt ihre Überschriften und Stichpunkte in den Prompt. Es gibt eine vollständige Kopie, die als Fallback im Workflow hartcodiert ist, sodass der Bot bei einem Notion-Ausfall trotzdem läuft, statt den PR fehlschlagen zu lassen. Beim ersten Test lieferte der Notion-Abruf einen 404 zurück und der Bot nutzte still den Fallback. Dieser 404 bedeutete, dass die Seite nicht mit der Integration geteilt worden war, nicht dass das Token falsch war. Notion gibt „not found” zurück, nicht „forbidden”, wenn einer Integration der Zugriff fehlt. Gut zu wissen, bevor Sie am falschen Ende debuggen.
4. Claude Haiku liest das Diff und bleibt beratend
Das Review ist ein Aufruf an Claude Haiku. Es bekommt die Checkliste und das Diff und liefert einen Kommentar zurück, der jeden relevanten Punkt als erledigt, prüfenswert oder verletzt markiert, und endet mit einem Gesamtrisiko in Grün, Gelb oder Rot samt einem Satz, der begründet, warum.
Zwei Entscheidungen waren wichtig. Erstens meldet er nur, was für das Diff relevant ist: Eine reine Backend-Änderung wird nicht wegen mobiler Touch-Ziele bemängelt. Zweitens, und daran haben wir am festesten gehalten, ist er beratend. Der Workflow endet immer erfolgreich. Er lässt die Prüfung nie fehlschlagen, nur weil der Code Lücken hat. Er kommentiert, und ein Mensch entscheidet. Ein Merge-Block an die Meinung eines LLM zu koppeln, ist ein guter Weg, um Ihrem Team beizubringen, das Werkzeug zu verachten und seine Ausgabe blind abzunicken.
Er ist außerdem günstig. Haiku betreibt das für ungefähr einen bis fünf Dollar im Monat für das gesamte Team. Ein einzelner Copilot-Enterprise-Platz kostet neununddreißig. Und der Kommentar aktualisiert sich an Ort und Stelle: Jeder Push löscht den alten Bot-Kommentar und postet einen frischen, sodass der PR nie einen Stapel veralteter Reviews ansammelt.
5. Die Backend-Checkliste entstand beim Lesen eines echten Backends
Die Frontend-Checkliste existierte bereits als Notion-Seite, die das Team über die Zeit aufgebaut hatte. Die Backend-Checkliste gab es überhaupt nicht. Also schrieben wir sie, indem wir den besten FastAPI-Service profilierten, den wir betreiben, smartopz-backend, und im eigenen Code nachlasen, wie „gut” tatsächlich aussieht: Routen, die an Controller delegieren, explizite Statuscodes und Response-Modelle, Pydantic, das die Validierung übernimmt, eine JWT-Abhängigkeit auf geschützten Routen, jede Query auf ihren Mandanten begrenzt.
Und jetzt der nützliche Teil. Das Referenz-Repo verletzte mehrere seiner eigenen Ideale. Passwörter wurden mit blankem sha256 gehasht. Das Logging lief über die ic()-Aufrufe von icecream, inklusive des Nutzerpassworts beim Login. Es gab eine pytest-Konfiguration und nicht einen einzigen Test. Nichts davon ist ein Vorwurf an das Team, das es unter Zeitdruck gebaut hat. Es ist einfach wahr, und es bedeutete, dass die Lücken in unserem besten Repo die wertvollsten Regeln zum Festhalten waren: bcrypt oder argon2, niemals sha256; Logging über die Standardbibliothek, niemals ic() in einem Request-Pfad; niemals eine Zugangsinformation loggen; Tests für neue Endpunkte. Die Checkliste kodiert den Standard, den wir wollen, nicht den, den die Referenz zufällig erfüllte.
6. Bewiesen haben wir es mit einem guten und einem schlechten PR
Um zu prüfen, ob der Bot etwas Nützliches tut, öffneten wir zwei Demo-PRs pro Stack: einen zum Bestehen geschrieben, einen zum Durchfallen.
Der durchfallende Backend-PR kassierte ein Rot. Er hatte ein hartcodiertes JWT-Secret und eine hartcodierte Datenbank-URL, eine per String-Verkettung gebaute SQL-Query, sha256-Hashing, das im Log ausgegebene Passwort und ein blankes except, das jeden Fehler verschluckte. Die Urteilszeile lautete „Nicht mergen.” Korrekt.
Der ehrliche Teil ist der bestehende PR. Auch unser erstes „regelkonformes” Backend-Beispiel kam rot zurück. Der Bot wies darauf hin, dass die Logik inline in der Route lag, ohne Controller-Schicht, und dass es keine Tests gab. Beides wahr und beides Dinge, die wir der Checkliste als wichtig mitgegeben hatten. Wir schrieben die Demo in eine saubere Route-Controller-Schema-Aufteilung mit einer pytest-Suite um, und es sank auf Gelb. Der Bot legte einen höheren Maßstab an als das Beispiel, das wir zum Bestehen geschrieben hatten, was man sich von einem Reviewer wünscht und etwas peinlich zuzugeben ist.
7. Dreiundachtzig Repos, per PR, in eine Wand aus 404ern
Der Rollout bedeutete, jedes aktive Frontend- und Backend-Repo anzufassen: 83 an der Zahl. Wir taten es, indem wir in jedem einen Pull Request öffneten, nicht indem wir den Workflow direkt in den Default-Branch committeten. Jeder PR fügt die Aufruf-Datei hinzu, und daneben setzten wir die zwei Secrets, die die Aufruf-Datei weiterreicht.
Dann fing GitHub an, uns anzulügen. Mitten im Massenlauf lieferten Aufrufe plötzlich 404er für Repos zurück, die offensichtlich existierten. Das Kern-Rate-Limit stand bei 5000 von 5000, komplett voll, was die naheliegende Erklärung ausschloss. Es war das sekundäre Limit, GitHubs Anti-Missbrauchs-Drossel für schnelle Schreibvorgänge, und die kündigt sich nicht höflich an. Sie lässt Anfragen einfach auf verwirrende Weise fehlschlagen. Die Lösung war, langsamer zu werden: Pausen zwischen den Repos, kleinere Batches, Retries bei den Lesevorgängen. Schnell durch die API zu preschen ist genau das, was die API zurückschlagen lässt.
Einen Kompromiss haben wir offen in Kauf genommen: Der Anthropic-Key liegt jetzt als Secret in 83 separaten Repos. Auf einem persönlichen GitHub-Konto gibt es kein Secret auf Organisationsebene, das man teilen könnte, also bekommt jedes Repo seine eigene Kopie. Die saubere Variante bräuchte eine echte GitHub-Organisation, was eine größere Entscheidung ist als ein Nachmittag Tooling.
8. Die Gates, die wir fanden und bewusst nicht aufbrachen
Beim Mergen der 83 Rollout-PRs zeigte uns die Flotte ihre wahre Sicherheitshaltung, und die war vielfältiger als erwartet. Siebenundvierzig mergten ohne Widerstand. Vierzehn hatten klassischen Branch-Schutz, den ein Owner übergehen kann, also taten wir das. Die letzten einundzwanzig hatten Repository-Rulesets, die ein menschliches Review mit leerer Bypass-Liste verlangen. Niemand, nicht einmal der Konto-Owner, kann diese ohne eine Freigabe mergen.
Wir ließen alle einundzwanzig zum Review offen. Wir hätten jedes Ruleset bearbeiten können, um einen Owner-Bypass hinzuzufügen und sie durchzuzwingen, und für etwa eine Minute fühlte sich das an wie das Erledigen der Aufgabe. Dann kam das Offensichtliche: Der ganze Sinn dieses Bots ist es, menschliches Review zu unterstützen. Einundzwanzig bewusst gesetzte Review-Gates niederzuwalzen, um ein Review-Tool zu installieren, wäre der sich selbst schreibende Witz gewesen. Also liegen sie in einer Warteschlange, und die Menschen, die diese Gates gesetzt haben, arbeiten sie in ihrer eigenen Zeit ab.
Eine kleinere Erkenntnis desselben Tages: „Nur diese zwei Personen dürfen mergen” ist nichts, was ein persönliches GitHub-Konto erzwingen kann. Personenbezogene Merge-Beschränkung ist ein Organisationsfeature. Gut, das herauszufinden, bevor man es jemandem verspricht.
9. Wo es auftaucht, und was kaputtging
Das letzte Stück ist Slack, denn dort lebte die „Kann das jemand mergen?”-Gewohnheit. Wenn ein PR geöffnet wird, postet ein eingehender Webhook eine Karte in den Channel.
Die erste Version postete das gesamte Review nach Slack. Jeder PR wurde zu einer Textwand, und der Channel wurde schlechter, nicht besser. Wir bauten es als kompakte Karte neu auf: eine Kopfzeile, die Frontend oder Backend sagt, der verlinkte Titel und Autor, eine Zeile mit dem Risiko-Urteil und der Hinweis, nicht zu mergen, bevor die Checks durchgelaufen sind. Das vollständige Review bleibt am PR. Der Channel ist jetzt in etwa zwei Sekunden pro PR erfassbar.
Und die Teile, die kaputtgingen, ganz offen, denn eine aufgeräumte Fallstudie ist eine unehrliche. Unter dem Rate-Limit wurde unsere Branch-Erkennung wackelig und las falsch aus, welche Repos einen Staging-Branch hatten. Wir merkten es, weil ein Teammitglied wusste, dass ein Repo Staging hatte, und der Bot beharrte, dass dem nicht so sei. Zwei Repos wurden während des Rollouts von jemandem umbenannt oder gelöscht und rutschten unter dem Skript weg. Ein Repo landete mit geschlossenem Rollout-PR und ohne Ersatz, verwaist, wartend auf ein erneutes Anlegen, sobald die Drossel nachlässt. Nichts davon ist ein Designfehler. Es ist die Textur davon, 83 Live-Repositories auf einmal über eine API zu ändern, die dafür gebaut ist, einen auszubremsen. Nächstes Mal: Zustand mit Retries erkennen, den alten PR niemals schließen, bevor der neue bestätigt offen ist, und in Zehnerbatches ausrollen.
Fragen zum Build
Blockiert er Merges?
Nein, so ist es gewollt. Der Workflow ist immer erfolgreich; er kommentiert den PR und postet nach Slack, und die Merge-Entscheidung bleibt bei einem Menschen. Die Repos mit harten Merge-Gates haben sie, weil ihre Teams Rulesets gesetzt haben, und die haben wir in Ruhe gelassen.
Wie viel kostet der Betrieb?
Der einzige laufende Kostenpunkt ist die Anthropic-API, mit Claude Haiku, dem günstigsten Modell. Für ein Team unserer Größe landet das bei rund einem bis fünf Dollar im Monat. Ein einzelner Copilot-Enterprise-Platz kostet neununddreißig.
Warum die Checkliste in Notion statt in einer Datei im Repo?
Damit die Menschen, denen der Qualitätsmaßstab gehört, ihn ändern können, ohne einen Pull Request zu öffnen. Der Workflow liest die Seite live zur Laufzeit, mit einer hartcodierten Kopie im Workflow als Fallback, sodass ein Notion-Ausfall niemanden blockiert.
Ist das intern, oder etwas, das Sie für einen Kunden bauen würden?
Wir haben es zuerst für unsere eigenen 83 Repos gebaut. Weil es ein wiederverwendbarer Workflow plus eine 15-zeilige Aufruf-Datei ist, ist das Einbinden in die Organisation eines Kunden ein Kopieren, ein Einfügen und zwei Secrets. Die Checkliste ist nur eine Notion-Seite, also bearbeitet ein Kunde seinen eigenen Maßstab.
Was ist noch holprig?
Ehrlich gesagt drei Dinge. Ein Rollout-PR ist verwaist und muss neu angelegt werden. Die Notion-Seiten müssen noch mit der Integration geteilt werden, damit der Bot die Live-Checkliste statt seines Fallbacks liest. Und der API-Key, der in 83 Repos liegt, wäre als einzelnes Secret in einer echten GitHub-Organisation sauberer.