KI / Self-Hosted
Ein Konversations-Bot, der in einem einzigen Container läuft, ohne externe Dienste
Frontend, Backend, Datenbank und LLM-Client alle zusammen gebündelt. Wird als einzelner Container auf Docker oder Railway deployt. Setzen Sie ihn in jede Umgebung, ohne zusätzliche Infrastrukturanforderungen.
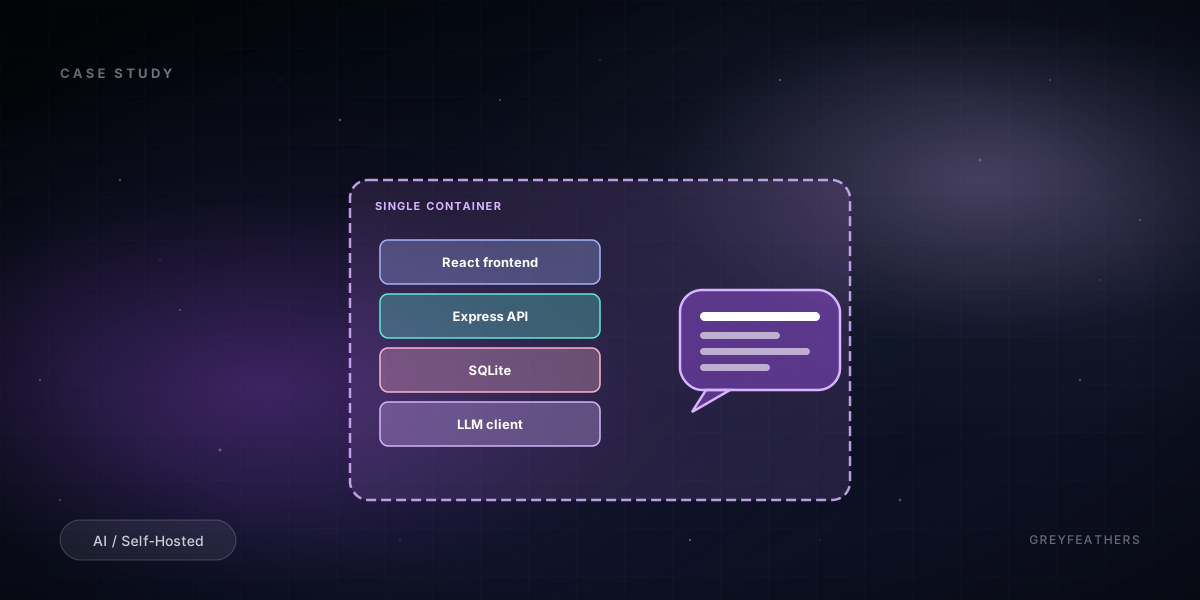
Die meisten Chatbots benötigen einen ganzen Infrastruktur-Stack, um zu laufen. Einen Datenbankdienst, einen Backend-Dienst, ein Frontend-Deployment, eine separate Hosting-Ebene für den LLM-Proxy. Für interne Tools oder beim Kunden ausgerollte Integrationen ist dieser Aufwand ein Ausschlusskriterium.
Das Briefing war ein eigenständiger Bot. Ein Container, der das Frontend, das Backend, die Datenbank und den LLM-Client enthält. Deployen Sie ihn überall dort, wo ein Container läuft. Keine externen Dienste bereitzustellen.
Was wir gebaut haben
1. Single-Process-Architektur
Express bedient die API. Derselbe Express-Prozess liefert auch das gebaute React-Frontend als statische Dateien aus. SQLite übernimmt die Persistenz innerhalb des Containers. Der einzige externe Aufruf geht an den LLM-Anbieter.
- Express-Backend, das sowohl API als auch statisches Frontend bedient
- SQLite für den Konversationsverlauf
- React-Frontend, vom selben Prozess gebaut und ausgeliefert
- Deployment als einzelner Container auf Docker oder Railway
2. Konversationsoberfläche
Die Chat-UI folgt dem üblichen Muster gestreamter Nachrichten. Nachrichten werden in SQLite persistiert, sodass der Konversationsverlauf einen Container-Neustart übersteht.
- Streaming-Darstellung von Nachrichten, während Token eintreffen
- Konversationsverlauf über Sitzungen hinweg persistiert
- Unterstützung für Datei-Uploads als Kontextanhänge
- Leichtgewichtige UI ohne externe Schrift- oder Asset-Abhängigkeiten
3. Austauschbarer LLM-Client
Der LLM-Aufruf sitzt hinter einer dünnen Abstraktion. Groq ist der Standard für Geschwindigkeit. Der Wechsel zu OpenAI oder Anthropic ist eine Konfigurationsänderung, keine Codeänderung.
- Anbieterunabhängiger LLM-Client
- Groq als Standard für schnelle Inferenz
- Per Konfiguration auf OpenAI oder Anthropic umstellbar
Tech-Stack und warum wir ihn gewählt haben
Eigenständigkeit war die Vorgabe. Jede Entscheidung wurde getroffen, um sie zu wahren.
- Express für das Backend. Das einfachste ausgereifte Node-Framework. Bedient API und statische Dateien aus einem Prozess ohne Umstände.
- SQLite für die Persistenz. Eine einzige Datei innerhalb des Containers. Kein separater Datenbankdienst zu betreiben. Die Performance ist für den Konversationsverlauf mehr als ausreichend.
- React mit Vite für das Frontend. Vite erzeugt einen schnellen, kleinen Build, den Express als statische Dateien ausliefert. Kein separates Frontend-Deployment.
- Multer für die Verarbeitung von Datei-Uploads. Standard-Express-Middleware.
- Groq-SDK für den LLM-Client. Schnellste Inferenz zu diesem Preispunkt. Die dünne Abstraktion darum macht den Anbieterwechsel trivial.
- Lucide React für die Ikonografie. Geringer Bundle-Einfluss, einheitliches Design.
- Docker oder Railway für das Deployment. Ein Container, ein Prozess, ein binäres Ziel.
Ergebnis
Als einzelnes Artefakt deploybar. Setzen Sie ihn in jede Umgebung, die einen Container ausführt; er funktioniert.
Häufig gestellte Fragen
Wie steht es um die Skalierung?
Für interne Tools und Deployments je Kunde ist ein einzelner Container die richtige Größenordnung. Wächst ein Deployment darüber hinaus, erlaubt die Architektur, die SQLite-Schicht in eine verwaltete Datenbank auszulagern und den Container hinter einem Load Balancer zu replizieren. Diese Komplexität haben wir aufgeschoben, bis sie gebraucht wird.
Wie wird der Konversationsverlauf gesichert?
Die SQLite-Datei ist ein einzelnes Artefakt. Backups sind Dateikopien. Das Wiederherstellen ist ein Ersetzen der Datei. Einfacher als eine verwaltete Datenbank für die Größenordnung, in der dieses Produkt läuft.